GLM-5.3 montre que la Chine ne suit pas juste par distillation
Le billet d’Interconnects défend une idée simple : la progression des modèles chinois ne s’explique pas seulement par la distillation, c’est-à-dire l’apprentissage sur les sorties d’un autre modèle. Avec GLM-5.3, le sujet devient très concret pour les développeurs : un modèle orienté code et sécurité, assez performant pour que Z.ai retarde de deux semaines la publication de ses poids ouverts.
Fil « GLM-5.3 reste dans la course »
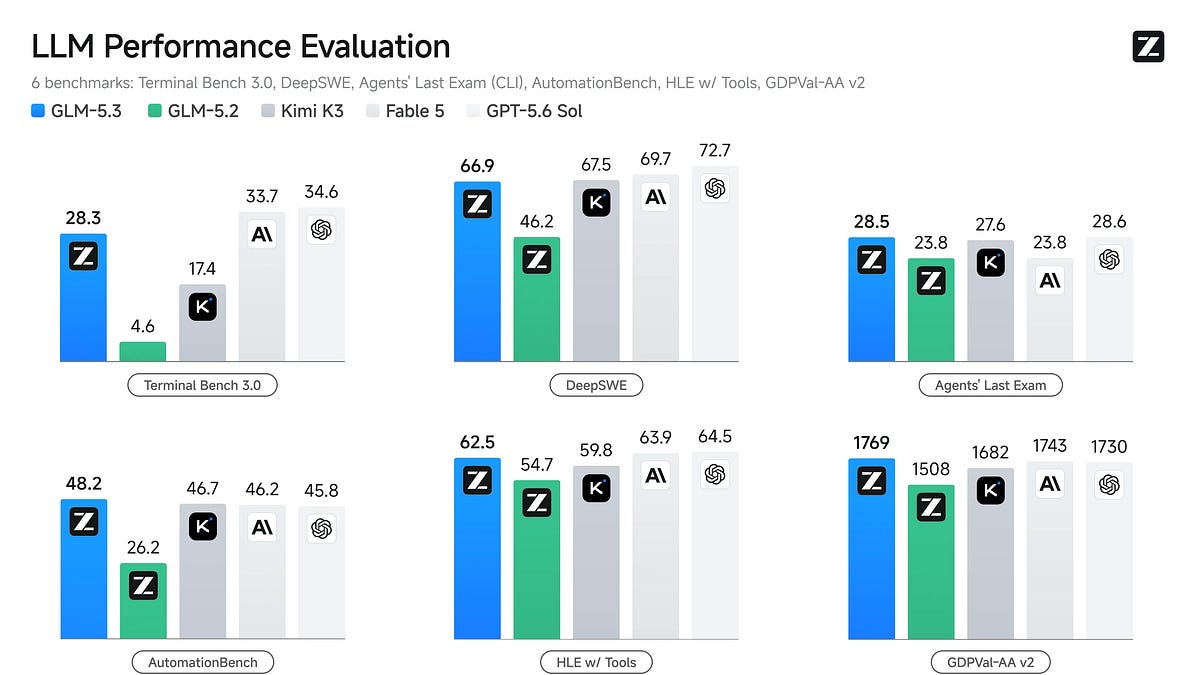
Le point important du papier source est moins “GLM-5.3 est bon” que pourquoi il l’est. Nathan Lambert soutient que raconter les avancées chinoises comme une simple histoire de distillation (technique qui consiste à entraîner un modèle sur les réponses d’un autre) est réducteur : la distillation est une pratique standard de l’industrie, y compris chez les grands laboratoires, mais elle n’explique pas à elle seule le rythme des progrès observés. Son analyse met davantage l’accent sur un travail minutieux sur toute la pile — données, architecture, post-entraînement (phase d’ajustement après le pré-entraînement initial) et infrastructure — ainsi que sur un écosystème où les laboratoires apprennent vite les uns des autres. Il note aussi qu’une grande partie du calcul sert à la R&D (recherche et développement), pas seulement au “grand entraînement final” : une estimation citée place cette part autour de 80 %. (interconnects.ai)
Ce que GLM-5.x change concrètement pour les équipes produit
Côté usage développeur, la série GLM-5 de Z.ai est clairement positionnée pour l’agentic engineering (développement assisté par agents, c’est-à-dire des modèles capables d’enchaîner planification, appels d’outils et modifications de code). La documentation officielle de Z.ai affirme que GLM-5 atteint un niveau proche de Claude Opus 4.5 sur des tâches d’ingénierie logicielle, avec 77,8 sur SWE-bench Verified (banc d’essai de correction de tickets logiciels réels) et 56,2 sur Terminal Bench 2.0 (évaluation de tâches réalisées en terminal), en le présentant comme le meilleur modèle à poids ouverts sur ces repères. Z.ai décrit aussi des usages très concrets : refactorisation backend, débogage profond et exécution de tâches longues avec peu d’intervention humaine. Pour une équipe qui utilise déjà des assistants de code, le message est net : on n’est plus sur du simple auto-compléteur, mais sur des workflows plus proches d’un binôme autonome. (docs.z.ai)
Pourquoi GLM-5.3 attire l’attention maintenant
L’actualité du jour renforce ce diagnostic. Selon Axios, publié le 14 août 2026, Z.ai a annoncé que GLM-5.3 était assez performant en cybersécurité pour que l’entreprise retarde de deux semaines la publication des poids ouverts, le temps de renforcer ses contrôles de sûreté. L’entreprise met en place un accès par paliers avec des partenaires sécurité sélectionnés, et explique avoir entraîné le modèle à chercher des vulnérabilités dans des environnements contrôlés. Axios rapporte aussi un score de 84,5 % sur CyberGym (banc d’essai de recherche de failles connues), devant Anthropic Fable 5 et OpenAI GPT-5.6 Sol sur cette mesure précise. Autrement dit : le sujet n’est pas seulement la “course aux benchmarks” (mesures standardisées), mais l’arrivée d’un modèle code/sécu qui peut modifier la manière de tester, auditer et durcir des applications. (axios.com)
Ce qu’il faut en retenir dans la pratique
Pour un développeur, la leçon utile est double :
- Ne pas réduire les modèles chinois à du rattrapage passif : l’avantage semble venir aussi de l’organisation du travail, du partage d’enseignements et d’une obsession pour les tâches mesurables. (interconnects.ai)
- Surveiller la sécurité autant que la productivité : un agent plus fort en code est aussi potentiellement plus fort pour repérer — ou exploiter — des failles. (axios.com)
- Attendre des assistants plus autonomes dans les IDE (environnements de développement) et en ligne de commande, surtout sur refacto, debugging et enchaînement d’actions. (docs.z.ai)
Un exemple simple de garde-fou d’équipe, si vous commencez à brancher des agents de code sur des dépôts sensibles :
# Exemple de règle minimale avant exécution d'un agent de code
# 1) environnement isolé
# 2) pas d'accès prod
# 3) revue humaine obligatoire avant merge
export AGENT_SANDBOX=1
export PROD_ACCESS=0
export REQUIRE_HUMAN_REVIEW=1
La vraie information derrière GLM-5.3, c’est donc celle-ci : la frontière des assistants de développement reste très mouvante, et elle ne progresse pas uniquement grâce à la copie des leaders américains. Elle avance aussi grâce à une discipline industrielle sur les données, l’évaluation et l’outillage. Pour les équipes qui codent avec l’IA tous les jours, cela veut dire plus de concurrence utile — et plus d’exigence sur les garde-fous. (interconnects.ai)