Gemini 3.7 Flash : Google remet son modèle rapide au centre du jeu
Le billet d’AINews signalait un retour de Google DeepMind au premier plan grâce à Gemini 3.7 Flash. Ce qui ressort des annonces et du contexte récent, c’est moins une course au “plus gros modèle” qu’un pari sur le modèle rapide, moins cher et assez bon pour piloter des agents, coder et enchaîner des outils en production.
Fil « Gemini 3.7 Flash remet Google dans la course »
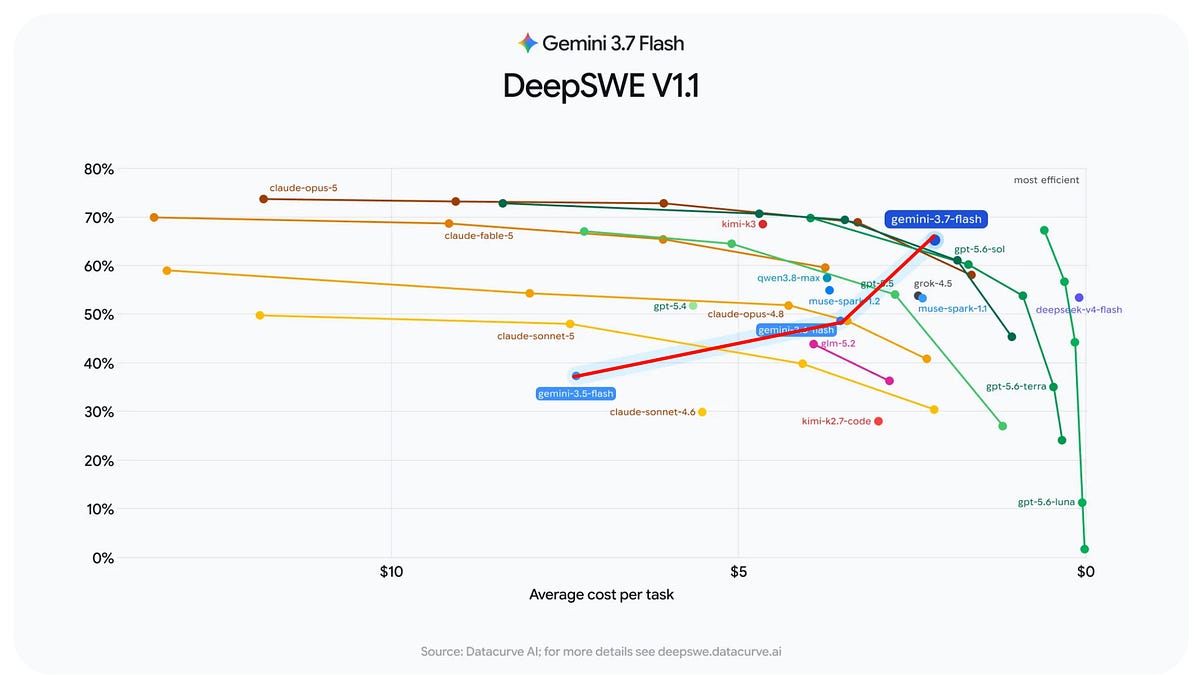
Le point important pour une équipe de développement, c’est le changement de priorité chez Google : la gamme Flash n’est plus seulement le “petit modèle rapide”, mais le cœur de son offre pour les usages concrets. Google avait déjà repositionné Gemini 3 Flash en décembre 2025 comme un modèle « de pointe construit pour la vitesse », disponible dans Google AI Studio, Vertex AI, Gemini CLI, Google Antigravity et l’application Gemini. Google disait alors traiter plus de 1 000 milliards de jetons par jour sur son API après le lancement de Gemini 3. (blog.google)
Ce que le billet AINews veut dire par « retour au premier plan »
Le billet source s’inscrit dans une séquence plus large : à Google I/O 2026, Google avait déjà présenté Gemini 3.5 Flash comme son modèle principal pour les agents (programmes qui enchaînent des actions), le code et les flux rapides, avec 1 million de jetons de contexte (la quantité de texte ou d’entrées que le modèle peut garder en mémoire sur une requête) et jusqu’à 65 000 jetons en sortie. Le même récapitulatif relayait aussi une lecture d’Artificial Analysis selon laquelle 3.5 Flash occupait la meilleure zone du compromis intelligence / vitesse. (latent.space)
Ce qui change concrètement pour les développeurs
Depuis, Google a continué à itérer sur cette famille au lieu de tout miser sur un seul modèle “premium”. Son billet du 21 juillet 2026 annonçait Gemini 3.6 Flash, 3.5 Flash-Lite et 3.5 Flash Cyber, avec un message très clair : il faut plus de latence basse (temps d’attente court), de fiabilité et d’efficacité en jetons pour faire tourner des agents en production. Google y affirme que 3.6 Flash réduit l’usage de jetons de sortie de 17 % par rapport à 3.5 Flash, et jusqu’à 65 % sur le benchmark DeepSWE de Datacurve, tout en gardant un prix de 1,50 $ par million de jetons d’entrée et 7,50 $ par million de jetons de sortie. (blog.google)
Pour un lecteur qui utilise déjà des assistants de code, la conséquence pratique est simple : la compétition se joue de plus en plus sur le coût par tâche terminée, pas seulement sur le score brut en benchmark. Google pousse aussi cet axe dans ses outils d’orchestration : à I/O 2026, ses managed agents (agents gérés par la plateforme) étaient décrits comme reposant sur Gemini 3.5 Flash via Antigravity et l’Interactions API (interface de programmation pour conversations et outils), ce qui montre que Flash sert de moteur opérationnel, pas juste de démo marketing. (blog.google)
Pourquoi ce retour compte
Le « retour de GDM » évoqué par AINews renvoie donc surtout à ça : Google DeepMind redevient visible parce qu’il aligne enfin modèle rapide, plateforme d’agents, outils développeur et déploiement produit. En clair, si votre équipe choisit un modèle pour du code, du support interne, des workflows IDE ou du multi-outils, il faut surveiller moins le prestige d’un modèle “raisonneur” et davantage ces critères :
- latence : réponse assez rapide pour rester utilisable dans un IDE ;
- coût de sortie : souvent le vrai poste de dépense dans les agents ;
- fenêtre de contexte : utile pour gros dépôts, logs ou specs ;
- stabilité d’appel d’outils : capacité du modèle à choisir et enchaîner les bonnes actions ;
- intégration : API, CLI, studio, cloud d’entreprise. (blog.google)
Un test minimal à faire en équipe consiste d’ailleurs à mesurer non pas “quel modèle répond le mieux à une question”, mais “quel modèle ferme le plus de tickets ou termine le plus de tâches de code pour 1 dollar”. Par exemple :
# Exemple de protocole maison
# 1) même lot de tickets
# 2) même outils autorisés
# 3) on mesure coût, latence et taux de réussite

run-benchmark \
  --models gemini-3.5-flash,gemini-3.6-flash \
  --dataset ./tickets.jsonl \
  --metrics success_rate,latency_ms,output_tokens,cost_usd
Le billet d’AINews avait raison sur le signal général : Google n’est pas revenu au centre de la discussion avec un slogan, mais en transformant Flash en modèle de travail pour les agents et le développement assisté par IA. Ce que Gemini 3.7 Flash ajoute précisément n’apparaît pas encore dans une annonce officielle Google que j’ai pu vérifier directement ; en revanche, le contexte documenté montre une trajectoire nette et récente : de Gemini 3 Flash en décembre 2025, à 3.5 Flash en mai 2026, puis 3.6 Flash en juillet 2026, Google a réinstallé sa ligne “rapide + assez intelligente + intégrée partout” au centre de sa stratégie. (blog.google)