Tencent dévoile Hy4 Preview un modèle open-weights géant de 770 milliards de paramètres
L'entreprise chinoise Tencent a publié Hy4 Preview, un nouveau modèle de langage à poids ouverts sans capacités de vision. Avec une fenêtre de contexte de 1 million de jetons et un volume de 1,56 To sur Hugging Face, cette version marque un bond technique important par rapport à la mouture précédente lancée en juillet.
Fil « Lancement du modèle open-weights Hy4 par Tencent »
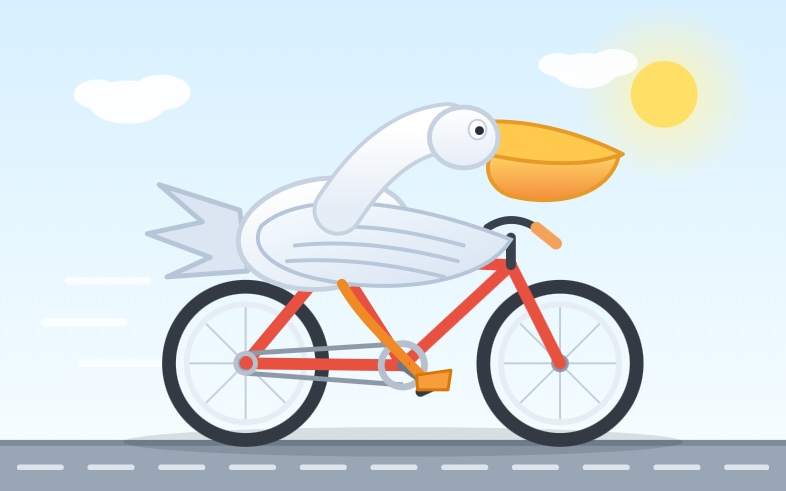
Le 29 août 2026, Tencent a mis en ligne Hy4 Preview, un nouveau modèle LLM (Large Language Model, ou grand modèle de langage) à poids ouverts (open-weights, dont les paramètres de réglage sont téléchargeables). Ce modèle traite uniquement du texte et atteint 1,56 To sur Hugging Face (la plateforme d'hébergement de modèles d'IA). La progression par rapport à Hy3, publié en juillet 2026, est particulièrement marquée :
- 770 milliards de paramètres au total (contre 295 milliards pour Hy3).
- 49 milliards de paramètres actifs lors du calcul d'un token (contre 21 milliards auparavant).
- 1 million de tokens de fenêtre de contexte (la quantité maximale de texte traitable d'un coup, contre 256 000 jetons pour Hy3).
Une gestion simplifiée de la réflexion dans le code
L'inspection du fichier chat_template.jinja (le fichier de gabarit qui formate les échanges entre l'utilisateur et l'IA) montre que le modèle intègre une logique de réflexion native (reasoning, la capacité à générer des étapes de pensée internes). Tencent y définit strictement deux niveaux d'effort de réflexion (reasoning_effort) : la valeur par défaut high (élevée) et la valeur no_think (désactivation du raisonnement).
Voici le segment du fichier Jinja qui contrôle ce comportement et lève une exception en cas de paramètre invalide :
{% - if not reasoning_effort is defined %}
  {% - set reasoning_effort = 'high' %}
{% - elif reasoning_effort not in [ 'high' , 'no_think' ] %}
  {% - if reasoning_effort is none %}
    {{- raise_exception('reasoning_effort error : None, should be no_think/high') }}
  {% - else %}
    {{- raise_exception('reasoning_effort error : ' + reasoning_effort + ', should be no_think/high') }}
  {% - endif %}
{% - endif %}
Des traces de réflexion écrites pour l'efficacité
Lors d'un test d'exécution via OpenRouter (un service d'accès centralisé aux modèles par API) demandant de générer une image au format SVG (Scalable Vector Graphics, un format d'image vectorielle) représentant un pélican à vélo, la trace de réflexion (reasoning trace, le journal textuel des pensées internes du modèle) a révélé un style rédactionnel particulier. Le modèle produit un anglais volontairement simplifié et synthétique :
"Let's maybe add a helmet? It could improve riding theme, but may obscure head. Maybe a small cycling cap or helmet? The user didn't ask; can add red helmet? Might be cute. But pelican with big beak; a helmet might obscure. Better maybe no."
Cette formulation écourtée dans la phase de réflexion cachée s'explique par le fait qu'une grammaire parfaite n'est pas nécessaire à la logique interne du modèle. Raccourcir ces phrases permet d'optimiser l'utilisation des tokens (tokens, les sous-unités de mots traitées par l'IA) et d'exécuter la phase de réflexion plus rapidement.