Apple met à jour ses Mac mini et Mac Studio pour l'inférence IA en local
Apple rafraîchit ses ordinateurs de bureau avec les puces M6 et M5 Ultra pour répondre à l'engouement des développeurs exécutant des modèles de langage en local. Grâce à la mémoire unifiée et à des connexions haut débit, la firme californienne propose une alternative concrète aux processeurs graphiques cloud coûteux.
Fil « Nouveaux Mac Studio et Mac Mini optimisés pour l'IA locale »
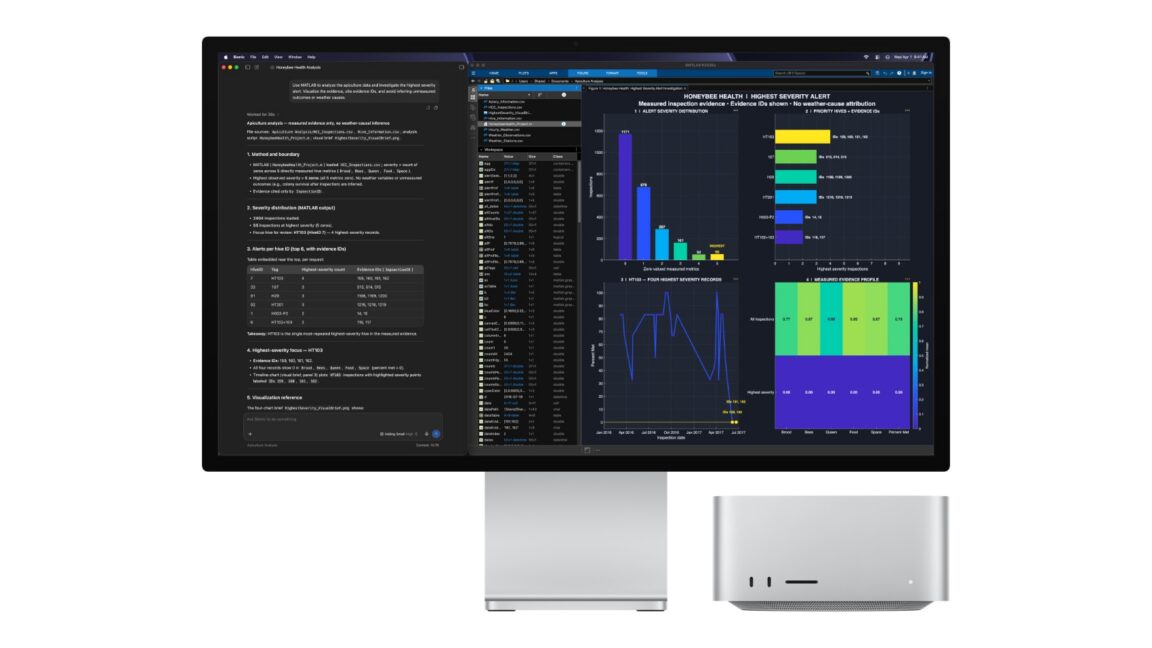
Des puces M6 et M5 Ultra taillées pour l'inférence locale
Apple a annoncé une mise à jour de ses ordinateurs de bureau Mac mini et Mac Studio. Cette révision technique cible directement l'inférence locale (l'exécution d'un modèle d'intelligence artificielle sur sa propre machine pour générer du code ou du texte). Le Mac mini intègre la nouvelle puce M6, premier SoC (System-on-a-Chip, un composant unique regroupant processeur et carte graphique) gravé en 2 nm (nanomètres) de la gamme M. Son CPU (processeur central) de 12 cœurs affiche des performances multicœurs jusqu'à 40 % plus rapides que la génération M4, épaulé par 160 Go/s de bande passante (débit de transfert de données) pour sa mémoire unifiée (RAM partagée directement entre le CPU et la carte graphique), limitée à 32 Go.
Pour les usages plus exigeants, le Mac Studio adopte la puce M5 Ultra. Conçue comme l'assemblage de deux puces M5 Max, elle embarque 36 cœurs CPU et 80 cœurs GPU (processeurs graphiques). Elle propose une capacité maximale de 512 Go de RAM et une bande passante mémoire colossale de 1,2 To/s.
Chainer des Mac pour contourner le coût des API cloud
Cette mise à niveau répond à une pratique croissante chez les développeurs : interconnecter plusieurs Mac en chaîne via Thunderbolt 5 (norme de connexion filaire à très haut débit) pour exécuter des modèles open-weight (modèles d'IA dont les paramètres sont librement téléchargeables, comme Qwen ou DeepSeek). Grâce au framework open source MLX (outil de calcul matriciel optimisé pour la mémoire unifiée des puces Apple) introduit avec macOS 26.2, les équipes font tourner localement des modèles volumineux sans payer de jetons (tokens, les unités de texte facturées par les fournisseurs d'IA cloud).
Pour lancer un modèle localement avec le framework MLX sur sa machine, l'exécutable s'utilise directement depuis le terminal :
# Exécution d'un modèle open-weight localement via la bibliothèque MLX
python -m mlx_lm.generate --model deepseek-ai/DeepSeek-R1 --prompt "Write a TypeScript interface"
Caractéristiques et tarifs des nouveaux modèles
Outre l'augmentation des performances de calcul, Apple a amélioré la connectivité et la vitesse d'accès aux données sur les deux machines :
- Processeur réseau N1 : support natif du Wi-Fi 7 et du Bluetooth 6.
- Vitesse de stockage : débit jusqu'à deux fois plus rapide, atteignant 15 Go/s.
- Mac mini M6 : disponible à partir de 899 $ (16 Go de RAM), version M5 Pro dès 1 699 $ (avec port Ethernet 2.5Gb de série, option 10Gb).
- Mac Studio M5 Max : proposé dès 2 499 $, avec une déclinaison M5 Ultra démarrant à 5 499 $.
Les précommandes ouvrent aujourd'hui pour des livraisons prévues le 22 septembre (la configuration 512 Go du Mac Studio sera disponible fin octobre) avec la sortie de macOS 27 Golden Gate.