Le post-training sort du flou avec le nouveau livre de Nathan Lambert
Nathan Lambert, chercheur connu pour son travail sur les modèles ouverts, annonce la sortie immédiate de son livre consacré au post-training, c’est-à-dire tout ce qu’on fait après le pré-entraînement d’un grand modèle. Au-delà de l’annonce, la page du livre détaille surtout ce qui intéresse les équipes produit et plateforme : les méthodes concrètes qui transforment un modèle brut en assistant utile, pilotable et déployable.
Fil « Un livre sur le post-training des modèles »
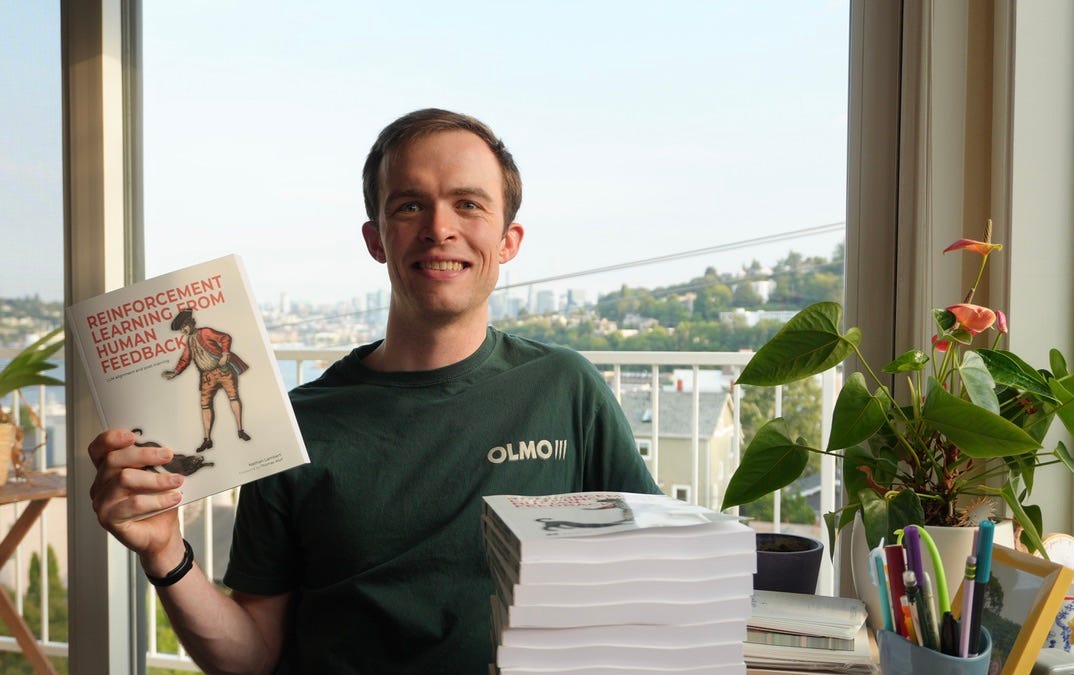
Nathan Lambert, fondateur de la newsletter Interconnects et ancien responsable du post-training chez Ai2 (Allen Institute for AI, institut de recherche à but non lucratif), présente son ouvrage Reinforcement Learning from Human Feedback: LLM alignment and post-training comme un manuel pratique centré sur l’alignement et le post-training des grands modèles de langage. La page éditeur indique une disponibilité en print, eBook et audio, avec une mise en vente constatée fin juillet 2026, et un contenu organisé en 17 chapitres courts plus des annexes sur le vocabulaire, les coûts de calcul et le suivi des performances d’entraînement. (manning.com)
Ce que le livre promet d’enseigner, concrètement
Le cœur du programme est très orienté pratique. L’éditeur met en avant :
- les implémentations centrales de RLHF (reinforcement learning from human feedback, apprentissage par renforcement à partir de préférences humaines) ;
- les Direct Alignment Algorithms (méthodes d’alignement direct, qui évitent certains détours classiques du RL) ;
- la construction de pipelines de données de préférence et de données synthétiques (jeux de données générés artificiellement pour entraîner ou corriger un modèle) ;
- l’évaluation des modèles et la création de personas ou comportements ciblés ;
- les compromis de coût de calcul et de latence (temps de réponse en production) ;
- plusieurs modes d’échec, dont le reward hacking (quand le modèle apprend à maximiser une métrique sans réellement mieux répondre) et la sur-optimisation qualitative. (manning.com)
Pourquoi c’est utile pour une équipe qui construit avec l’IA
Pour un développeur qui utilise déjà des assistants de code ou des agents, l’intérêt n’est pas de réentraîner un modèle de zéro, mais de mieux comprendre ce qui se passe entre un modèle de base et un produit fiable. La description du livre insiste justement sur les briques qui changent le comportement réel d’un assistant : instruction fine-tuning (réglage sur consignes), reward models (modèles qui notent une réponse), DPO (Direct Preference Optimization, optimisation directe à partir de préférences), function calling (capacité du modèle à appeler un outil externe) et inference-time scaling (techniques qui augmentent l’effort de calcul au moment de la réponse pour améliorer le résultat). Pour une équipe, cela aide à mieux lire les annonces des fournisseurs de modèles, à comprendre pourquoi deux assistants “sur le même modèle” se comportent différemment, et à choisir entre prompt, outil, données d’évaluation ou post-traitement avant d’ajouter une couche d’agentification. (manning.com)
Un signal intéressant sur l’état du domaine
Le contexte autour de Lambert renforce ce positionnement très terrain. Interconnects le présente comme une publication centrée sur les modèles, leurs méthodes d’entraînement et l’écosystème des modèles ouverts, et rappelle ses travaux sur OLMo, Tülu, RewardBench et d’autres références du post-training. Dans un épisode récent du podcast Interconnects, Lambert explique aussi que le domaine converge désormais vers quelques “recettes” dominantes et cite notamment la multi-teacher on-policy distillation (distillation par plusieurs enseignants, pendant l’apprentissage, pour transmettre des traces ou comportements utiles), signe que le post-training reste un champ mouvant mais de plus en plus structuré. Autrement dit : ce livre arrive à un moment où les pratiques sortent du bricolage artisanal pour devenir une pile technique plus lisible. (interconnects.ai)
Ce que ça change dans la pratique
Pour le lecteur de ce journal, la bonne lecture n’est pas “il faut faire du RLHF partout”, mais plutôt : les couches qui comptent vraiment dans vos outils IA sont souvent après le pré-entraînement. Si vous devez auditer un assistant interne, comparer des API de modèles ou mieux cadrer un agent de développement, voici les questions que ce type de cadre rend plus faciles :
- quelle part du comportement vient du prompt système et quelle part vient du post-training ;
- quels jeux de tests mesurent vraiment l’utilité, et pas seulement le style ;
- où apparaissent les coûts : données, calcul, latence, évaluation humaine ;
- à quel moment un modèle “semble meilleur” simplement parce qu’il a été optimisé pour une métrique précise. (manning.com)
Un bon réflexe d’équipe est d’ailleurs de formaliser cette lecture dans vos évaluations internes. Par exemple :
{
  "assistant": "code-review-agent",
  "eval_axes": ["justesse", "appel_outil", "latence", "respect_des_contraintes"],
  "suspect_post_training_effects": [
    "sur-optimisation du ton utile",
    "meilleur score benchmark mais moins bon en workflow réel",
    "appel d'outil excessif"
  ]
}
L’intérêt du livre de Lambert, à ce stade, est donc moins de vendre une nouvelle mode que de donner un vocabulaire commun pour discuter de ces effets sans folklore. C’est probablement sa valeur la plus concrète pour les équipes qui vivent déjà avec des copilotes, des agents et des modèles de plus en plus opaques. (manning.com)