Comment fonctionne le cycle de vie d'une requête sur PostgreSQL partitionné
PlanetScale détaille l'architecture interne d'un routeur distribué conçu pour PostgreSQL partitionné. Du protocole réseau à la planification de requêtes multi-serveurs, découvrez le parcours d'une commande SQL à travers un cluster à grande échelle.
Fil « Analyse du cycle de vie d'une requête dans un cluster PostgreSQL partitionné »
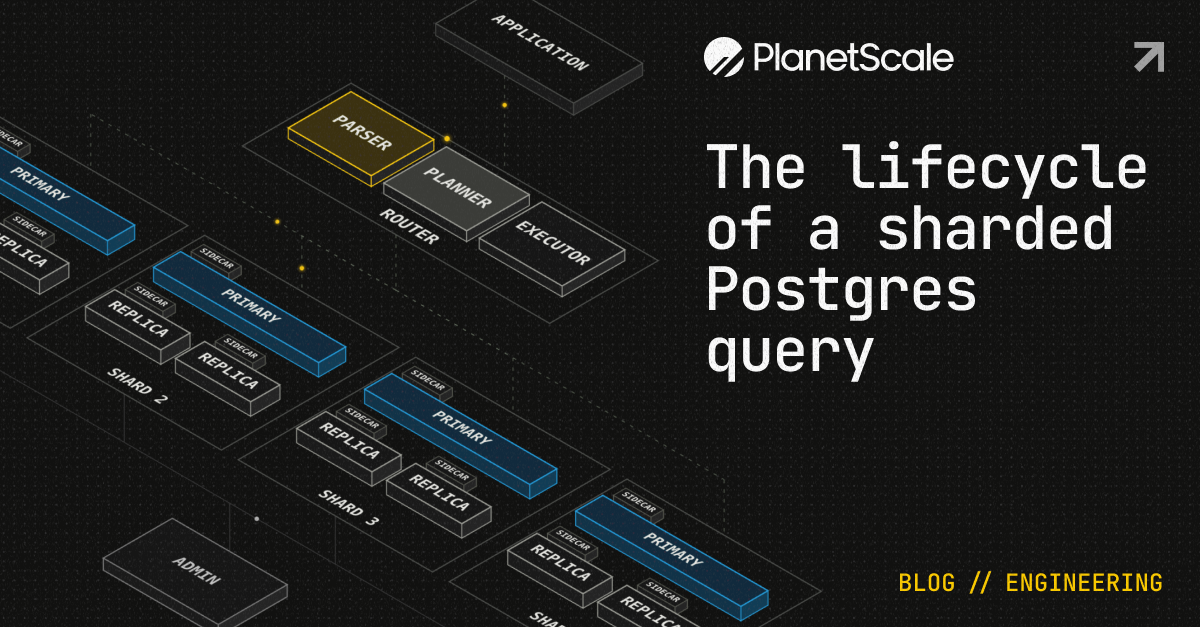
Lorsqu'une base de données PostgreSQL est distribuée sur plusieurs centaines de serveurs via le sharding (technique de partitionnement horizontal des données sur plusieurs serveurs), présenter le cluster sous la forme d'un serveur unique relève d'un défi d'ingénierie complexe. PlanetScale détaille le parcours d'une requête au travers d'un routeur spécialisé (nommé Neki), conçu pour masquer la distribution physique des nœuds aux applications clientes.
Authentification et gestion du protocole réseau
Avant d'exécuter la moindre commande, l'application s'authentifie directement auprès du routeur. Ce dernier simule intégralement le comportement de PostgreSQL en réimplémentant en Go le protocole SCRAM-SHA-256 (Salted Challenge Response Authentication Mechanism, un mécanisme d'authentification cryptographique par défi-réponse). Une fois le transfert TLS (Transport Layer Security) établi et les droits vérifiés, le routeur prend en charge les deux variantes du wire protocol (le protocole réseau de communication natif de PostgreSQL) :
- Le protocole simple : l'application envoie l'intégralité du texte SQL dans un seul message
Query. - Le protocole étendu : la requête est décomposée en 5 étapes clés (
Parse,Bind,Describe,ExecuteetSync), permettant de réutiliser les instructions préparées (prepared statements) pour éviter les phases répétitives d'analyse syntaxique.
Analyse syntaxique et construction de l'AST
Si aucun plan d'exécution n'est présent dans le cache, la requête sous forme de chaîne de caractères doit être analysée. Le routeur s'appuie sur un analyseur syntaxique (parser) d'environ 18 000 lignes de Go, conçu pour reproduire exactement la syntaxe du parser écrit en C de PostgreSQL. Cette étape transforme la commande SQL brute en un AST (Abstract Syntax Tree, ou arbre de syntaxe abstraite), une structure d'arbre intermédiaire décrivant les tables, les filtres et les conditions de jointure.
SELECT customers.name, orders.total, orders.created_at
FROM customers
JOIN orders ON orders.customer_id = customers.id
WHERE orders.created_at >= $1;
Planification distribuée et topologie du cluster
Une fois l'AST généré, le query planner (planificateur de requêtes distribué) doit déterminer la meilleure stratégie pour récupérer les données dispersées sur les différents fragments (shards). Contrairement à un serveur PostgreSQL unique, le planificateur distribué s'appuie sur deux sources d'informations critiques :
- Le fragment d'autorité (authoritative shard) : il fournit le schéma complet de la base de données (tables, colonnes et types) conservé dans un cache local.
- La topologie des données : stockée de manière centralisée dans etcd (un magasin clé-valeur distribué) et mise en cache sur chaque nœud du routeur.
Lorsque les clés de partitionnement (shard keys) choisies ne co-localisent pas les données associées sur le même serveur physique — comme dans l'exemple d'une clé basée sur customers.id et orders.id —, le planificateur génère un arbre de plan (débutant par un nœud de type JoinCluster) pour coordonner les opérations d'assemblage entre les différents nœuds.