Samsung LPDDR5X-PIM : le calcul au cœur de la DRAM sans changer de contrôleur
Lors de la conférence Hot Chips 2026, Samsung a présenté les détails techniques de son architecture LPDDR5X-PIM (Processing-in-Memory), qui intègre des blocs de calcul directement au sein des banques de mémoire DRAM. Si l'approche débloque une bande passante interne impressionnante de 614 Go/s, son intégration logicielle et son impact sur la gestion des caches processeur posent de complexes défis d'ingénierie.
Fil « Architecture des puces Processing-in-Memory (PIM) de Samsung »
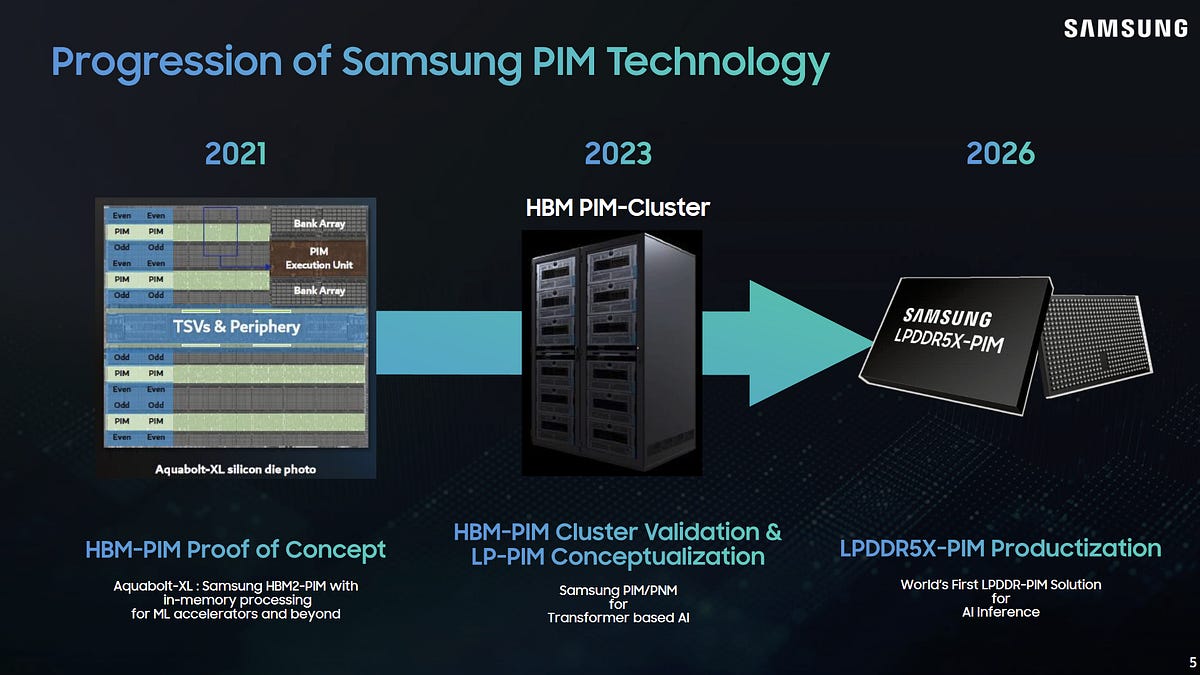
Du calcul embarqué directement dans la mémoire DRAM
Le principe du Processing-in-Memory (PIM, ou calcul directement au sein de la mémoire) consiste à placer des unités de traitement au plus près des cellules de stockage pour contourner le goulot d'étranglement du bus mémoire externe. Présentée lors de l'événement Hot Chips 2026, la puce LPDDR5X-PIM de Samsung conserve la compatibilité avec un contrôleur mémoire standard tout en intégrant des unités de multiplication-accumulation (MAC, pour Multiply-Accumulate) au niveau de chacune de ses 16 banques de DRAM.
En mode d'accès mémoire classique, le contrôleur ne peut solliciter que deux banques en parallèle, plafonnant le débit à 76,8 Go/s. En effectuant les opérations au niveau interne de chaque puce, l'architecture PIM exploite une bande passante cumulée de 614 Go/s. Chaque bloc PIM contient des registres d'instructions (1024 bits), de source (4 kbits) et d'échelle (2 kbits) capables d'exécuter des opérations en faible précision (INT8, FP8 et 4 bits) atteignant 2,4 TOPS (téra-opérations par seconde, soit 10^12 opérations) par composant.
Détourner le protocole DDR par des adresses réservées
Pour conserver une interface LPDDR5X standard sans ajouter de lignes physiques au bus, Samsung utilise une astuce matérielle : certaines adresses de lignes spécifiques sont réservées et agissent comme un espace d'entrées/sorties mappées en mémoire (MMIO, pour Memory-Mapped I/O). Le contrôleur bascule ainsi la puce entre un mode banque unique (single-bank) et un mode multi-banques (multi-bank).
En mode multi-banques, les commandes d'écriture transmises par le processeur hôte sont diffusées simultanément sur les 16 banques pour charger les registres d'instructions et de données du PIM. Une fois l'initialisation terminée, l'émission de simples commandes de lecture DDR déclenche les calculs internes au lieu de renvoyer des données sur le bus. Les résultats sont accumulés dans des registres vectoriels (VRF, pour Vector Register File) puis réécrits directement dans la mémoire DRAM.
// Exemple conceptuel du basculement MMIO et de l'exécution PIM
void execute_pim_op(volatile uint32_t* pim_region) {
    // Passager en mode multi-banques pour diffuser les instructions PIM
    pim_region[PIM_MODE_CTRL] = MULTI_BANK_PIM_ENABLE;
    // Écriture des vecteurs d'entrée dans les registres d'instructions/sources
    load_pim_registers(pim_region, input_vector);
    // Une lecture DDR déclenche le calcul interne au sein des 16 banques
    volatile uint32_t trigger = pim_region[PIM_EXECUTE_READ];
    // Réécriture des résultats du VRF vers les cellules DRAM
    pim_region[PIM_WRITEBACK_CMD] = 1;
    // Retour au mode mémoire standard
    pim_region[PIM_MODE_CTRL] = SINGLE_BANK_NORMAL;
}
Un défi pour le système d'exploitation et le multitâche
Cette altération du comportement des commandes DDR standard pose de lourdes contraintes aux noyaux des systèmes d'exploitation. Comme le basculement en mode PIM modifie la signification des instructions de lecture et d'écriture au niveau physique de la puce, tout accès concurrent issu d'un autre thread risquerait de corrompre l'état des registres PIM ou d'invalider les calculs en cours.
Pour garantir l'isolation, le système d'exploitation doit réserver des canaux mémoire dédiés et renoncer à l'entrelacement des adresses (memory interleaving, technique répartissant la charge sur plusieurs canaux). En environnement multitâche préemptif, le noyau devrait soit bloquer l'ensemble des interruptions pendant le calcul, soit sauvegarder intégralement l'état des registres PIM de chaque puce lors de chaque changement de contexte, ce qui engendrerait un surcoût processeur massif.
Incompatibilité avec les caches CPU et l'exécution spéculative
La contrainte la plus sévère concerne l'interaction avec la hiérarchie de mémoire cache (L1, L2, L3) du processeur. Les lectures envoyées à la zone PIM ayant des effets de bord matériels (le déclenchement d'un calcul), la plage d'adresses correspondante doit obligatoirement être déclarée non cachable (uncacheable).
L'invalidation du cache impose d'interdire également la pré-lecture de données (prefetching) ainsi que l'exécution spéculative (speculative execution). Si le prédicteur de branchement du CPU venait à exécuter une lecture spéculative dans la zone PIM pour une branche de code non empruntée, cette lecture déclencherait un calcul parasite et modifierait irréversiblement les registres vectoriels, ruinant la cohérence des calculs.