Compilation JIT à très basse latence : générer du code machine ARM64 en 5 microsecondes
Alors que les compilateurs JIT traditionnels basés sur LLVM pâtissent de temps de compilation élevés, l'approche copy-and-patch permet d'émettre des instructions binaire directes en un temps record. En générant du code machine ARM64 en seulement 5 microsecondes, il devient possible de compiler à la volée chaque requête ou expression sans pénalité de latence.
Fil « Techniques de compilation JIT à très basse latence »
Le verrou des temps de compilation JIT
La compilation JIT (Just-In-Time, ou compilation à la volée pendant l'exécution) offre des gains de performance de 2x à 5x — et parfois bien plus — en exploitant des informations connues uniquement à l'exécution. Historiquement, la conception d'un compilateur JIT rapide nécessitait une écriture manuelle complexe en langage d'assemblage (code assembleur directement exécutable par le processeur). Pour éviter cette complexité, la plupart des moteurs modernes et des bases de données s'appuient sur l'infrastructure LLVM (une chaîne de compilation modulaire très répandue) ou génèrent du code C/C++. Le problème réside dans les temps de compilation élevés de ces outils, ce qui restreint leur usage à un sous-ensemble très réduit d'opérations.
Pour lever ce verrou, la technique du copy-and-patch permet d'atteindre des temps de compilation de l'ordre de 5 microsecondes (5 μs). Ce niveau de latence extrêmement bas permet de compiler à la volée la totalité des opérations traitées, comme chaque requête SQL ou l'évaluation d'expressions régulières, sans impacter la réactivité globale du système.
L'approche copy-and-patch et les stencils
Le principe du copy-and-patch repose sur l'utilisation de stencils (des pochoirs d'instructions binaires pré-générés). Chaque structure de l'AST (Abstract Syntax Tree, ou arbre syntaxique abstrait représentatif du code) est associée à un modèle d'instructions en langage machine. Lors de la phase de compilation, le moteur se contente d'enchaîner ces pochoirs et d'y injecter directement à chaud les données dynamiques, telles que les offsets (décalages mémoire) ou les caractères à comparer.
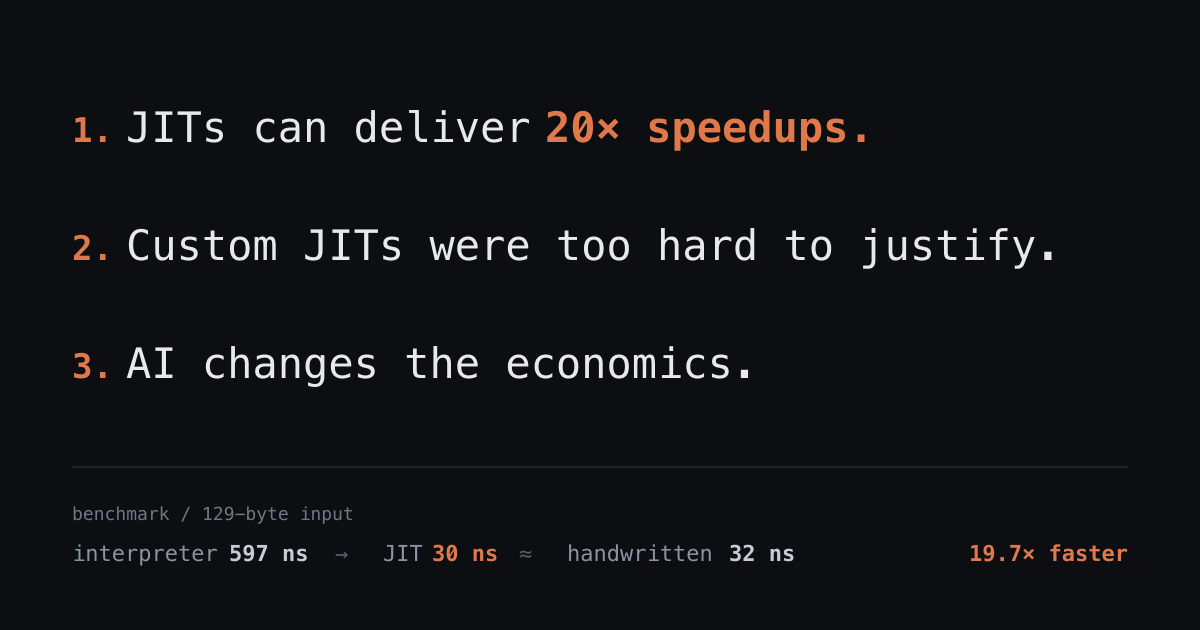
Prenons l'exemple d'un moteur d'expressions régulières simplifiées. Un interpréteur classique qui parcourt l'arbre syntaxique subit un surcoût important par rapport à du code écrit à la main. Les mesures de performance montrent que le code compilé à la main est 10 à 20 fois plus rapide que l'interpréteur. L'objectif du JIT par stencils est d'atteindre exactement cette performance native en assemblant directement du code ARM64 (l'architecture processeur 64 bits d'ARM).
Anatomie du code ARM64 généré
Pour une expression régulière comme b(an)*, le compilateur JIT génère une suite d'instructions machine exploitant des registres (des espaces de stockage ultra-rapides au cœur du processeur) prédéfinis :
- x0 : pointeur vers la position actuelle dans la chaîne de caractères et valeur de retour.
- x1 et x2 : pointeurs du haut et du bas de la pile dédiés au backtracking (moteur de retour en arrière en cas d'échec de correspondance).
- x9 : registre temporaire pour le chargement et la comparaison d'octets.
L'exécution s'articule autour de blocs d'instructions binaires distincts : la vérification du caractère 'b' (ldrb w9, [x0]), l'empilement de l'état d'échec pour la boucle de répétition (an)* (stp x9, x0, [x1]), puis la logique de repli (fallback) qui dépile les adresses en cas de non-correspondance (ldp, br x9).
Assemblage dynamique d'instructions en Rust
En pratique, la génération des mots de code ARM64 (sur 32 bits chacun) s'implémente au moyen de fonctions simples retournant des tableaux d'entiers non signés. Chaque fonction applique un masque binaire pour modifier les bits représentant la valeur du caractère ou le saut conditionnel :
const CHAR_WORDS: usize = 4;

fn stencil_char(byte: u8, stencil_pos: usize, fail_pos: usize) -> [u32; CHAR_WORDS] {
    [
        0x39400009, // ldrb w9, [x0] (charge l'octet courant)
        0x7100013F | ((byte as u32) << 10), // cmp w9, #byte (compare avec le caractère)
        0x54000001 | cond_branch_offset(stencil_pos + 2, fail_pos), // b.ne fail (saut si inégal)
        0x91000400, // add x0, x0, #1 (avance dans la chaîne)
    ]
}
Une fois ces instructions générées en mémoire puis copiées dans un segment de mémoire rendu exécutable, le runtime Rust peut invoquer cette séquence exactement comme une fonction native. La suppression de la phase d'analyse de LLVM permet d'éliminer la latence d'initialisation et de garantir un gain de vitesse immédiat de 10x à 20x sur l'exécution.